ADMET 분할 방식이 성능 추정을 얼마나 바꾸는지 재봤습니다
약물이 몸에 어떻게 흡수되고 대사되고 빠져나가는지를 미리 예측하는 모델을 ADMET 모델이라 부릅니다. 후보 물질을 임상으로 보낼지 판단하는 자리에서 씁니다.
이 모델을 학습용과 평가용으로 어떻게 나누느냐에 따라 성능 숫자가 달라집니다. 얼마나 달라지는지 공개 데이터로 재봤습니다. 결론부터 적으면, 업계 표준인 scaffold split에서는 12개 과제 중 8개만 성능이 떨어지는데 화학적 거리로 나누면 12개 전부 떨어집니다. 하락 폭도 중앙값 +0.020에서 +0.098로 커집니다.
분할 방식이 문제가 되는 이유
머신러닝에서 데이터를 학습용과 평가용으로 나눌 때, 두 쪽에 비슷한 것이 섞이면 성능이 부풀려집니다. 시험에 나올 문제를 연습 문제로 미리 준 것과 같습니다. 이걸 데이터 누수(data leakage)라고 합니다.
화합물에서는 이 문제가 특히 심합니다. 신약개발에서는 뼈대 하나를 잡고 곁가지만 바꿔 가며 수십에서 수백 개 유도체를 만들기 때문입니다. 아스피린을 붙들고 아세틸기 자리를 이리저리 바꿔 보는 식입니다. 이렇게 나온 한 묶음을 시리즈(analog series)라고 부르는데, 안에 있는 화합물들은 서로 매우 닮았습니다.
무작위로 나누면 그 유도체 100개 중 80개가 학습에, 20개가 평가에 들어갑니다. 모델은 구조가 성질을 어떻게 좌우하는지(structure-property relationship)를 배우지 않고도 “이 뼈대는 대충 이런 값”을 외워서 좋은 점수를 받습니다.
표준 관행: scaffold split
여기서 말하는 뼈대가 scaffold입니다. 정확히는 Bemis-Murcko scaffold라고 하는데, 분자에서 말단 곁사슬(side chain)을 전부 떼고 고리(ring)와 고리를 잇는 링커(linker)만 남긴 것입니다. 아스피린이라면 아세틸기와 카복실기를 떼고 남는 벤젠 고리가 scaffold입니다.
scaffold split은 같은 scaffold를 가진 화합물을 통째로 한쪽에만 넣는 방식입니다. 아스피린 유도체 100개는 전부 학습에 들어가거나 전부 평가에 들어갑니다. 나눠 담지 않습니다.
ADMET 벤치마크의 표준 관행이고, Therapeutics Data Commons 리더보드도 이 기준으로 순위를 매깁니다. 그런데 최근 논문 몇 편이 scaffold split으로는 누수가 다 잡히지 않는다고 보고했습니다. Fooladi 등[1]은 TDC 8개 데이터셋에 분할 10종과 모델 14종을 교차해 scaffold 분할이 열 가지 중 가장 쉬운 시험임을 보였고, Zheng 등[3]은 라벨을 쓰지 않는 분할을 제안해 BBB 과제에서 AUROC가 0.879에서 0.409로 내려가는 것을 보고했습니다.
이유는 이렇습니다. scaffold가 다르다는 것과 화학적으로 멀다는 것이 같은 말이 아닙니다. 벤젠 고리와 피리딘 고리는 고리에 질소가 하나 들어갔는지 차이뿐이라 scaffold로는 다른 분자인데 성질은 비슷합니다. scaffold만 갈라 놓으면 이런 닮은꼴이 학습과 평가 양쪽에 남습니다.
대안: 화학적 거리로 나누기
닮았는지를 재려면 분자를 숫자로 바꿔야 하는데, 그때 쓰는 것이 fingerprint입니다.
분자는 원자와 결합으로 이뤄진 그래프이고 대부분의 머신러닝 모델은 그 형태를 그대로 입력받지 못합니다. 그래서 2048칸짜리 스위치판을 하나 두고, 분자 안에 특정 부분구조가 있으면 해당 칸을 켜는 식으로 바꿉니다. Morgan fingerprint 2048이라고 부르고 ECFP라는 이름으로도 씁니다.
두 분자가 얼마나 닮았는지는 두 스위치판에서 켜진 칸이 얼마나 겹치는지로 잽니다. 겹친 칸을 전체 켜진 칸으로 나눈 값이 Tanimoto 유사도이고 0에서 1 사이입니다. 0.4를 넘으면 화학적으로 가깝다고 보는 것이 관행입니다.
구조 분리 분할은 Tanimoto 0.4 이상인 화합물을 하나로 묶어 통째로 배정합니다. scaffold가 서로 달라도 분자끼리 닮았으면 같은 쪽으로 보냅니다.
세 분할을 나란히 놓으면 이렇습니다.
| 분할 | 무엇을 같은 쪽에 묶나 |
|---|---|
| 무작위 | 아무것도 묶지 않음 |
| scaffold split | scaffold가 같은 것 |
| 구조 분리 | 화학적으로 가까운 것 전부 |
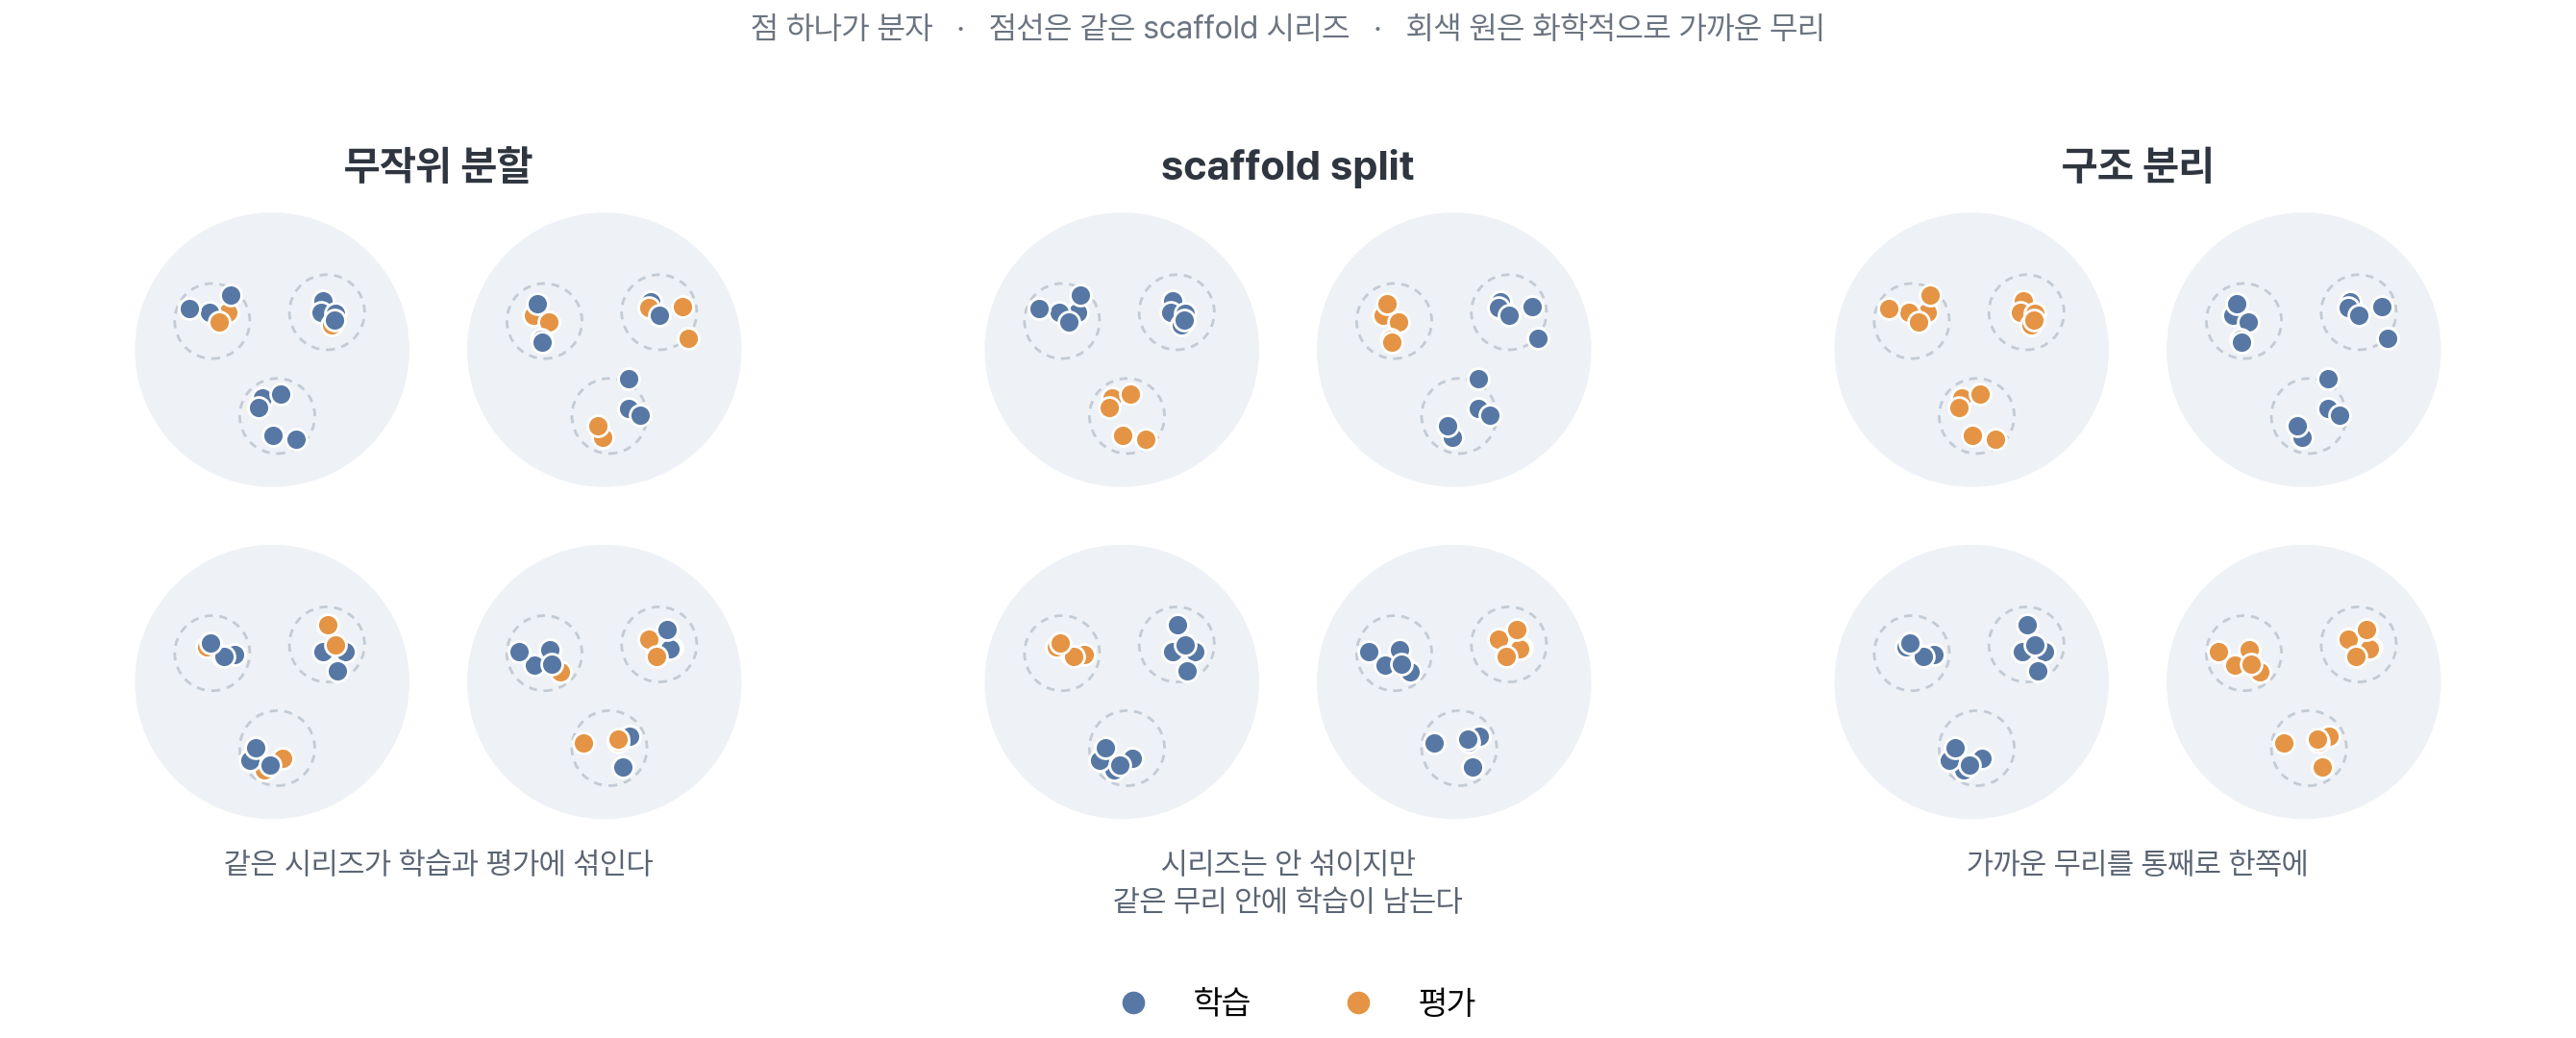
실험 설계
데이터는 Therapeutics Data Commons의 ADMET 12개 과제에 사람 약동학(PK) 3개 과제를 더했습니다. TDC는 하버드 Zitnik 랩이 운영하는 공개 플랫폼으로, 신약개발 머신러닝 데이터셋을 같은 규격으로 정리해 리더보드까지 제공합니다. ADMET 부문은 22개 데이터셋으로 이뤄져 있습니다.
같은 데이터와 같은 분할 로직을 두고 모델 계열 셋으로 돌렸습니다.
| 모델 | 분자를 어떻게 다루나 |
|---|---|
| Morgan fingerprint 2048 + LightGBM | 손으로 만든 스위치판 |
| 메시지 전달 신경망 | 그래프 구조에서 직접 학습 |
| ChemBERTa-77M 미세조정 | 사전학습 언어모델 |
분할별로 하이퍼파라미터를 따로 튜닝하지 않았습니다. 튜닝하면 분할 효과와 튜닝 효과가 섞입니다.
scaffold split과 구조 분리의 차이
fingerprint + LightGBM, 12개 과제, 시드 5개. 무작위 분할 대비 하락입니다.
| 분할 | 하락 중앙값 | 떨어진 과제 |
|---|---|---|
| scaffold split | +0.020 | 8 / 12 |
| 구조 분리 | +0.098 | 12 / 12 |
하락 폭보다 개수가 눈에 띕니다. scaffold split에서는 네 과제가 오히려 올라갑니다. 부호가 뒤집힙니다. 구조 분리에서는 그 네 과제까지 모두 떨어져 12개가 같은 방향이 됩니다.
세 모델 계열에서 결과가 같았습니다.
| 모델 계열 | scaffold 하락 중앙값 | 구조 분리 하락 중앙값 | 떨어진 과제 |
|---|---|---|---|
| fingerprint + LightGBM | +0.020 | +0.098 | 12 / 12 |
| 그래프 신경망 | +0.022 | +0.132 | 11 / 12 |
| ChemBERTa | +0.016 | +0.088 | 12 / 12 |
36개 과제-모델 쌍 가운데 35개가 구조 분리에서 떨어집니다. scaffold split에서는 23개입니다. 분자를 다루는 방식을 스위치판에서 그래프로, 다시 언어모델로 바꿔도 결론이 같습니다.
후보 선별에서 더 큰 차이
상관계수는 후보를 고르는 자리에서 직접 쓰이지 않습니다. 실제로 쓰는 것은 예측값 상위 몇 개를 가져가는지라, 상위 10% 적중률을 따로 쟀습니다. 시드 15개, 8개 과제이고 검정은 윌콕슨 부호순위 검정(Wilcoxon signed-rank test)입니다.
| 분할 | 하락 중앙값 | 떨어진 과제 | 부호순위 검정 |
|---|---|---|---|
| scaffold split | +0.066 | 8 / 8 | p = 0.0078 |
| 구조 분리 | +0.107 | 8 / 8 | p = 0.0078 |
과제별로는 사람 분포용적(VDss)의 낙차가 가장 큽니다. 0.358에서 0.176으로 내려가고 p < 0.001입니다. 분포용적은 약물이 몸에서 얼마나 넓게 퍼지는지를 나타내는 값으로, 사람에서의 투여량을 정할 때 씁니다. 학습 데이터와 화학적으로 먼 화합물이 들어오면 그 예측의 상위 후보 적중률이 절반 수준이 된다는 뜻입니다.
구현 편향 여부 확인
성능이 떨어진 원인이 두 가지로 갈릴 수 있었습니다. 화학적으로 가까운 것을 묶어 나눴기 때문일 수도 있고, 큰 묶음이 학습 쪽으로 몰리는 바람에 평가 집합이 외톨이 분자로만 채워졌기 때문일 수도 있습니다. 후자라면 제 구현이 만든 결과입니다.
대조군을 두 개 두었습니다. 하나는 같은 Tanimoto 묶음을 쓰되 배정만 완전히 무작위로 합니다. 다른 하나는 묶는 방법 자체를 선행 연구의 k-means 방식으로 바꿉니다.
| 성분 | 하락 중앙값 | 떨어진 과제 |
|---|---|---|
| 묶어서 나눈 효과 | +0.069 | 12 / 12 |
| 외톨이 분자가 평가 집합에 몰린 효과 | +0.026 | 7 / 12 |
하락의 약 73%가 묶어서 나눈 데서 왔습니다. 배정을 완전히 무작위로 돌려도 scaffold split의 두 배 넘게 떨어지고 12개 과제 전부에서 떨어집니다. 묶는 방법을 k-means로 바꿔도 하락 중앙값이 0.111과 0.087로 통계적으로 구분되지 않습니다(p = 0.301).
임계값을 올린 재현
Tanimoto 0.4에서는 큰 데이터셋 셋에 거대한 묶음이 생깁니다. 임계값을 0.5로 올려 12개 과제를 다시 돌렸습니다.
세 어려운 분할 모두 12개 과제 전부에서 떨어지고 p = 0.0005입니다. 성분 분해는 오히려 깨끗해집니다. 묶음 효과가 +0.082(12/12)로 커지고 외톨이 효과는 +0.004(6/12)로 사실상 사라집니다. 0.4에서 관측된 외톨이 효과는 거대한 묶음이 배정 순서를 왜곡해 생긴 것으로 보입니다.
정정한 것
처음 정리한 결론 가운데 셋을 철회했습니다.
선별 지표가 성능 지표보다 3.8배 빨리 무너진다고 적었는데, 시드를 5개에서 15개로 늘리자 1.7배였습니다. 방향은 남지만 크기가 훨씬 작습니다.
사람 PK 선별이 scaffold split에서 크게 무너진다고 적었는데, ChemBERTa로 다시 하니 사람 분포용적이 0.418에서 0.418로 변하지 않았습니다. fingerprint 기반 모델에서만 나타나는 현상입니다. 모델 계열을 가로질러 남는 것은 구조 분리 쪽입니다.
무작위 분할 성능으로 모델을 고르는 문제는 이 설계로 답할 수 없다고 판단해 비워 두었습니다. 모델이 세 계열뿐이라 “잘하는 모델이 어디서나 잘한다”가 상관을 지배합니다. 선행 연구는 성능이 비슷한 모델 14종의 순위가 뒤바뀌는지를 봤습니다. 세 점으로 순위 안정성을 재기는 어렵습니다.
선행 연구와 맞지 않은 두 지점
Guo와 Ding[2]은 26개 종점 165,541건에 네 모델 계열을 적용해 무작위에서 구조 분리로 갈 때 고전 머신러닝이 가장 많이 잃는다고 보고했습니다. 이 실험은 순서가 반대로 그래프 신경망이 가장 많이 잃었습니다. 시드를 2개에서 5개로, epoch을 60에서 100으로 늘려도 유지됩니다. 원인은 아직 가리지 못했고 종점 구성과 모델 규격을 후보로 봅니다.
Fooladi 등[1]은 scaffold split에서 상위 K 선별이 1.8 퍼센트포인트 떨어진다고 보고했는데 이 실험은 6.6이었습니다. 정의를 맞춘 뒤에도 3.7배 차이가 납니다. 분류 적중률과 회귀 상위 K% 선별이 다른 문제라는 점, 데이터셋 크기 차이를 후보로 봅니다. 이것도 확인하지 못했습니다.
범위
scaffold split이 낙관적이라는 것과 어려운 분할에서 성능이 떨어진다는 것은 이미 문헌에 있습니다. 이 실험은 그 결과를 재현하고, 하락이 묶어서 나눈 데서 오는지 구현에서 오는지를 대조군으로 갈라 본 것입니다. 12개 과제와 세 모델이라는 규모의 한계도 그대로 있습니다.
참고문헌
[1] Fooladi H, Vu TNL, Mathea M, Kirchmair J. Evaluating Machine Learning Models for Molecular Property Prediction: Performance and Robustness on Out-of-Distribution Data. J Chem Inf Model 2025;65(19):9871-9891. doi:10.1021/acs.jcim.5c00475
[2] Guo J, Ding S. arXiv:2604.26498 (2026). arxiv.org/abs/2604.26498
[3] Zheng J, Guo C, Wang Z, Liu X. arXiv:2607.10729 (2026). arxiv.org/abs/2607.10729
데이터는 Therapeutics Data Commons ADMET Benchmark Group을 썼습니다.